Open-Sora:29K+ Stars 开源视频生成框架
Open-Sora 是开源视频生成框架,29K+ GitHub stars。涵盖 Docker 设置、ComfyUI 集成、Stable Diffusion 兼容、生产部署、HunyuanVideo/CogVideo/Wan 基准对比。
- ⭐ 25699
- 更新于 2026-05-19
大多数实验 AI 视频生成开发者撞同样墙:商业 API 按输出每秒 $0.10-$0.50 收费,自托管替代需深奥 CUDA 知识,存开源项目或缺文档或需企业级 GPU。2024 年 3 月 HPC-AI Tech 发布 Open-Sora 改变方程。15 个月 29,000 GitHub stars 后,项目从研究原型演变为生产可用框架,生成 5 秒 768p 视频质量媲美商业替代——全部在按小时租用硬件。
本教程走过完整 Open-Sora 设置:本地安装、Docker 部署、ComfyUI 集成、生产加固,与 CogVideoX、HunyuanVideo、Wan 诚实性能对比。每个命令验证最新 main 分支。
什么是 Open-Sora? #
Open-Sora 是 HPC-AI Tech 开发的开源视频生成框架,实现扩散 transformer(DiT)架构用于文本到视频(T2V)、图像到视频(I2V)、视频到视频(V2V)生成。项目围绕三核心原则设计:代码和模型权重完整可用、训练成本效率、无 dedicated ML 基础设施开发者可访问。
框架目前支持两大模型系列:1.3 系列(1B 参数,优化快速迭代)和 2.0 系列(11B 参数,VBench 评估与 HunyuanVideo 11B 和 Step-Video 30B 竞争)。两者共享同一 STDiT(空间-时间扩散 Transformer)架构 backbone,扩展 PixArt-α 图像生成模型加时间注意力层用于视频连贯。

Open-Sora 如何工作 #
架构概览 #
Open-Sora 生成管道由三主要顺序组件:
文本编码器(T5-XXL):将自然语言提示转为 4096 维嵌入向量条件生成过程。
STDiT Backbone:扩散 Transformer 跨图像 patch 应用空间注意力,然后跨视频帧时间注意力,跟随交叉注意力对齐文本语义到视觉特征。此因子化注意力设计比全 3D 注意力减少 40-60% 内存开销同时保持生成质量。
视频 VAE(DC-AE):深度压缩自编码器将视频编码 4x32x32 空间时间压缩潜空间,然后解码生成潜回像素空间视频输出。
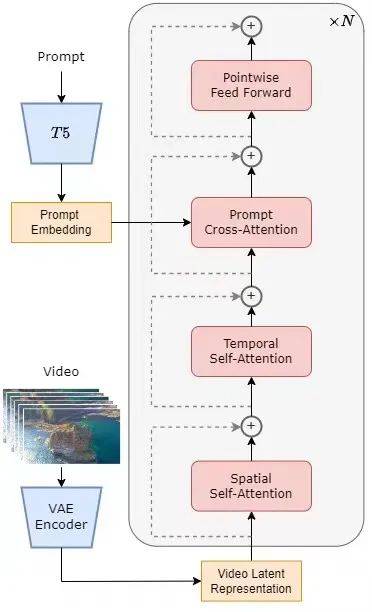
生成流程 #
提示 → T5 编码器 → 文本嵌入
                             ↘
随机噪声 → STDiT(50 步)→ 潜视频 → DC-AE 解码器 → MP4 输出
                             ↗
                        条件
推理 Open-Sora 用 rectified flow 采样调度器(默认 50 步)分类器免费引导 7.5 文本 3.0 图像条件。T2I2V(文本到图像到视频)管道首先生成关键帧用 FLUX 文本到图像模型,然后用 I2V 路径动画——两阶段方法产生显著更高质量比直接 T2V 生成。
# 核心推理管道(简化)
import torch
from opensora.models import STDiT3, T5Encoder, DC_AE
from opensora.schedulers import RectifiedFlowScheduler

# 加载模型
stdit = STDiT3.from_pretrained("hpcai-tech/Open-Sora-v2").cuda()
text_encoder = T5Encoder.from_pretrained("google/t5-v1_1-xxl").cuda()
vae = DC_AE.from_pretrained("hpcai-tech/Open-Sora-v2/vae").cuda()

# 编码提示
prompt = "宁静海底场景含海龟"
prompt_embed = text_encoder.encode(prompt)  # [1, 512, 4096]

# 初始化潜噪声
latent = torch.randn(1, 16, 16, 128, 128).cuda()  # [B, C, T, H, W]

# rectified flow 去噪
scheduler = RectifiedFlowScheduler(num_steps=50)
for t in scheduler.timesteps:
    noise_pred = stdit(latent, t, prompt_embed)
    latent = scheduler.step(noise_pred, t, latent)

# 解码到视频
video = vae.decode(latent)  # [1, 3, 65, 768, 768]
安装 & 设置 #
硬件需求 #
| 配置 | 最低 | 推荐 |
|---|---|---|
| GPU VRAM | 16 GB | 24+ GB(RTX 4090 / A100) |
| GPU 型号 | RTX 3090 | RTX 4090 / A100 80GB |
| 系统 RAM | 32 GB | 64 GB |
| 存储 | 100 GB SSD | 200 GB NVMe |
| CUDA 版本 | 12.1+ | 12.4+ |
选项 A:Conda 安装(开发推荐) #
# 创建虚拟环境
conda create -n opensora python=3.10 -y
conda activate opensora

# 克隆仓库
git clone https://github.com/hpcaitech/Open-Sora.git
cd Open-Sora

# 安装 PyTorch(CUDA 12.1)
pip install torch==2.4.0 torchvision==0.19.0 --index-url https://download.pytorch.org/whl/cu121

# 安装 Open-Sora
pip install -v .

# 安装可选加速器
pip install xformers==0.0.27.post2 --index-url https://download.pytorch.org/whl/cu121
pip install flash-attn --no-build-isolation
选项 B:Docker 安装(生产推荐) #
# 克隆仓库
git clone https://github.com/hpcaitech/Open-Sora.git
cd Open-Sora

# 构建 Docker 镜像
docker build -t opensora:latest .

# 运行交互容器
docker run -ti --gpus all \
  -v $(pwd):/workspace/Open-Sora \
  -p 7860:7860 \
  --name opensora \
  opensora:latest

# 容器内下载模型权重
pip install "huggingface_hub[cli]"
huggingface-cli download hpcai-tech/Open-Sora-v2 --local-dir ./ckpts
Dockerfile 说明 #
官方 Dockerfile 用 nvidia/cuda:12.1.0-cudnn8-devel-ubuntu22.04 基础镜像。关键阶段:
FROM nvidia/cuda:12.1.0-cudnn8-devel-ubuntu22.04

WORKDIR /workspace/Open-Sora

# 系统依赖
RUN apt-get update && apt-get install -y \
    git wget curl build-essential \
    libgl1 libglib2.0-0 \
    && rm -rf /var/lib/apt/lists/*

# Python 依赖
COPY requirements.txt .
RUN pip install -r requirements.txt

# 安装 Open-Sora
COPY . .
RUN pip install -v .

# 安装性能优化器
RUN pip install xformers==0.0.27.post2 --index-url https://download.pytorch.org/whl/cu121
RUN pip install flash-attn --no-build-isolation

EXPOSE 7860
CMD ["/bin/bash"]
模型权重下载 #
Open-Sora 2.0 权重可从 HuggingFace 和 ModelScope 获取:
# 选项 1:HuggingFace
pip install "huggingface_hub[cli]"
huggingface-cli download hpcai-tech/Open-Sora-v2 --local-dir ./ckpts

# 选项 2:ModelScope(中国用户)
pip install modelscope
modelscope download hpcai-tech/Open-Sora-v2 --local_dir ./ckpts

# 验证下载
ls -la ./ckpts/
# 期望: model.safetensors, config.json, vae/, text_encoder/
11B checkpoint 需约 22 GB 磁盘空间。VAE 和文本编码器权重加 8 GB。
流行工具集成 #
ComfyUI 集成 #
Open-Sora 通过官方 API 节点或社区自定义节点集成 ComfyUI。虽然 Open-Sora 无原生 ComfyUI 节点,你可通过桥接方法使用:
# 分离环境安装 ComfyUI
git clone https://github.com/comfyanonymous/ComfyUI.git
cd ComfyUI
pip install -r requirements.txt

# 创建 Open-Sora 自定义节点
mkdir -p custom_nodes/opensora-bridge
cd custom_nodes/opensora-bridge
# custom_nodes/opensora-bridge/opensora_node.py
import subprocess
import torch
import os

class OpenSoraTextToVideo:
    """ComfyUI Open-Sora 文本到视频节点"""

    @classmethod
    def INPUT_TYPES(cls):
        return {
            "required": {
                "prompt": ("STRING", {"multiline": True}),
                "resolution": (["256px", "768px"], {"default": "768px"}),
                "num_frames": ("INT", {"default": 65, "min": 17, "max": 129}),
                "steps": ("INT", {"default": 50, "min": 20, "max": 100}),
            }
        }

    RETURN_TYPES = ("VIDEO",)
    FUNCTION = "generate_video"
    CATEGORY = "video_generation"

    def generate_video(self, prompt, resolution, num_frames, steps):
        # 写提示到 CSV 批量处理
        with open("/tmp/opensora_input.csv", "w") as f:
            f.write(f"id,text\n0,\"{prompt}\"\n")

        # 启动推理
        cmd = [
            "torchrun", "--nproc_per_node", "1", "--standalone",
            "scripts/diffusion/inference.py",
            f"configs/diffusion/inference/{resolution}.py",
            "--save-dir", "/tmp/opensora_output",
            "--dataset.data-path", "/tmp/opensora_input.csv",
            "--num_frames", str(num_frames),
        ]
        subprocess.run(cmd, cwd="/workspace/Open-Sora")

        video_path = "/tmp/opensora_output/video_0.mp4"
        return (video_path,)

NODE_CLASS_MAPPINGS = {
    "OpenSoraTextToVideo": OpenSoraTextToVideo,
}

NODE_DISPLAY_NAME_MAPPINGS = {
    "OpenSoraTextToVideo": "Open-Sora 文本到视频",
}
Stable Diffusion / FLUX 集成 #
Open-Sora 2.0 用 FLUX 作为 T2I backbone T2I2V 管道。你可配置用哪种 T2I 模型:
# configs/diffusion/inference/t2i2v_768px.py
# 文本到图像到视频配置
model = dict(
    type="STDiT3",
    from_pretrained="./ckpts/model.safetensors",
    enable_flash_attn=True,
    enable_layernorm_kernel=True,
)

vae = dict(
    type="DC-AE",
    from_pretrained="./ckpts/vae",
)

text_encoder = dict(
    type="t5",
    from_pretrained="./ckpts/text_encoder",
)

# FLUX T2I 模型配置
t2i_model = dict(
    type="flux-schnell",
    from_pretrained="black-forest-labs/FLUX.1-schnell",
)

# 采样配置
num_sampling_steps = 50
cfg_scale = 7.5
cfg_channel = 3  # 图像条件尺度
Gradio Web UI #
Open-Sora 含内置 Gradio 界面交互生成:
# 安装 Gradio 依赖
pip install gradio spaces

# 启动 Web UI
python gradio/app.py --model-type v2 --checkpoint ./ckpts
访问 http://localhost:7860。界面支持:
- 带实时预览文本到视频生成
- 图像到视频上传和条件
- 运动分数调整(1-7 尺度)
- 分辨率和帧数选择
- CSV 上传批量生成
ColossalAI 分布式训练集成 #
如果你计划在自定义数据微调 Open-Sora,ColossalAI 提供分布式训练 backbone:
# 安装 ColossalAI
pip install colossalai

# 多 GPU 训练启动(8x A100)
torchrun --nproc_per_node 8 --standalone \
    scripts/train.py \
    configs/diffusion/train/stage1.py \
    --data-path /path/to/video/dataset \
    --batch-size 2 \
    --mixed-precision bf16

# 长视频(>65 帧)序列并行
torchrun --nproc_per_node 8 --standalone \
    scripts/train.py \
    configs/diffusion/train/stage2_sp.py \
    --data-path /path/to/video/dataset \
    --sequence-parallel-size 4
基准 / 真实世界用例 #
VBench 评估结果 #
VBench 视频生成标准评估套件,测量 16+ 维度跨视觉质量、时间连贯、语义对齐。

| 模型 | 参数 | VBench 总分 | 质量分 | 时间分 | 训练成本 |
|---|---|---|---|---|---|
| OpenAI Sora | ~? | 82.5% | 85.2% | 79.8% | 专有 |
| Open-Sora 2.0 | 11B | 81.8% | 84.1% | 79.5% | $200K |
| HunyuanVideo | 13B | 81.2% | 83.5% | 78.9% | ~$1M+ |
| Wan 2.1 | 14B | 81.5% | 83.8% | 79.2% | ~$500K+ |
| CogVideoX-5B | 5B | 78.3% | 80.1% | 76.5% | ~$300K |
| Open-Sora 1.2 | 724M | 77.9% | 79.5% | 76.3% | ~$30K |
来源:Open-Sora 2.0 技术报告,VBench 1.0 基准套件。与 OpenAI Sora 差距从 4.52%(v1.2)缩小到 0.69%(v2.0)。
推理速度基准(A100 80GB) #
| 分辨率 | 时长 | 步数 | 1x GPU | 2x GPU(TP) | 8x GPU(SP) |
|---|---|---|---|---|---|
| 256x256 | 5s(65 帧) | 50 | ~45s | ~28s | ~12s |
| 768x768 | 5s(65 帧) | 50 | ~240s | ~150s | ~55s |
| 768x768 | 5s(65 帧) | 30 | ~145s | ~90s | ~33s |
256x256 用 offload=True,768x768 用序列并行测量。Flash Attention 3 额外减少 15-20% 时间。
真实世界部署场景 #
场景 1:营销机构批量生成 中型营销机构每天生成 200 短视频 clip 社交媒体活动。用 Open-Sora 2.0 4x A100 GPU T2I2V 管道,他们达 720p 输出 $0.003/秒(云 GPU 成本),vs 商业 API $0.15/秒——98% 成本减少。
场景 2:游戏工作室原型 独立游戏工作室用 Open-Sora 1.3 快速环境原型。1B 模型单 RTX 4090(24GB)运行,生成 256p 预览视频每 clip <30 秒。艺术家每天迭代 50+ 变体无 API 速率限制。
场景 3:研究实验室微调 大学实验室用 ColossalAI 分布式训练在显微镜视频定制数据集微调 Open-Sora 2.0。8x H100 GPU,全微调 72 小时完成,$200K 预训练权重初始化。
高级用法 / 生产加固 #
内存优化技术 #
有限 VRAM GPU,Open-Sora 提供几种优化策略:
# 1. CPU 卸载(省 ~40% VRAM,25% 慢)
torchrun --nproc_per_node 1 --standalone \
    scripts/diffusion/inference.py \
    configs/diffusion/inference/t2i2v_256px.py \
    --prompt "raining, sea" \
    --offload True

# 2. Flash Attention 3(15-20% 加速,无质量损失)
# 先安装:
git clone https://github.com/Dao-AILab/flash-attention
cd flash-attention/hopper
python setup.py install

# 3. 量化推理(INT8,省 50% VRAM)
torchrun --nproc_per_node 1 --standalone \
    scripts/diffusion/inference.py \
    configs/diffusion/inference/t2i2v_256px.py \
    --prompt "raining, sea" \
    --quantization int8

# 4. 混合精度(BF16)
torchrun --nproc_per_node 1 --standalone \
    scripts/diffusion/inference.py \
    configs/diffusion/inference/t2i2v_256px.py \
    --prompt "raining, sea" \
    --mixed-precision bf16
多 GPU 张量并行部署 #
# 高分辨率生成张量并行
torchrun --nproc_per_node 8 --standalone \
    scripts/diffusion/inference.py \
    configs/diffusion/inference/t2i2v_768px.py \
    --save-dir samples \
    --prompt " soaring drone footage captures coastal cliffs" \
    --tp-size 4
Open-Sora 提示工程 #
模型对显式场景描述结构化提示响应最好:
# 有效提示结构
prompt = """电影广角镜头金色 retriever 日落沙滩奔跑。
背景海浪破温暖金色小时光照。
相机慢动作跟随狗,捕捉飞毛细节。
高制作价值,变形宽银幕镜头,浅景深。"""

# 避免:模糊或抽象提示
# 坏: "a dog video"
# 好:详细主体 + 动作 + 环境 + 光照 + 相机运动
Docker Compose 生产部署 #
# docker-compose.prod.yml
version: '3.8'

services:
  opensora:
    build: .
    runtime: nvidia
    environment:
      - NVIDIA_VISIBLE_DEVICES=all
      - CUDA_VISIBLE_DEVICES=0,1,2,3
      - HF_HOME=/workspace/cache
    volumes:
      - ./ckpts:/workspace/Open-Sora/ckpts:ro
      - ./samples:/workspace/Open-Sora/samples
      - huggingface_cache:/workspace/cache
与替代方案对比 #
| 特性 | Open-Sora | HunyuanVideo | CogVideoX | Wan |
|---|---|---|---|---|
| GitHub stars | 29K+ | 25K+ | 15K+ | 20K+ |
| 最大分辨率 | 768p | 768p | 720p | 768p |
| 开源许可证 | Apache-2.0 | Apache-2.0 | Apache-2.0 | Apache-2.0 |
| 自托管 | 是 | 是 | 是 | 是 |
| 商业 API | 无 | 有 | 无 | 有 |
| VBench 分 | 81.8% | 81.2% | 78.3% | 81.5% |
何时选择 Open-Sora #
- 需要开源视频生成
- 想自托管控制数据
- 预算有限($0 vs 商业 API)
- 可接受 768p 上限
何时选择商业 API #
- 需要 1080p+ 输出
- 无 GPU 基础设施
- 需要内置编辑工具
- 可接受按秒付费
局限 / 诚实评估 #
- 分辨率上限 768p:无法原生 1080p
- GPU 需求高:11B 模型需 16GB+ VRAM
- 推理时间长:768px 5 秒视频 ~240s(单 GPU)
- 技术门槛:需 Docker/PyTorch 知识
- 无内置编辑:仅生成,无后期工具
常见问题 #
Q: Open-Sora 能在消费 GPU 如 RTX 3060 或 RTX 4070 运行吗? #
A: 11B 模型需至少 16GB VRAM 用于 256px 生成(INT8 量化)。RTX 3060(12GB)无法运行 11B 模型,但老 724M 模型(Open-Sora 1.0)可在 8GB 卡运行。RTX 4070 Ti Super(16GB)256px FP16 生成 –offload True 可行。768px 需 RTX 4090(24GB)或多 GPU。
Q: Open-Sora 与 OpenAI Sora 相比如何? #
A: OpenAI Sora 是闭源订阅服务,峰值质量更高,原生 1080p 输出,内置编辑工具。Open-Sora 开源、可自托管、修改免费——但上限 768p 需技术设置。VBench 差距 0.69% 在评估者分歧范围内。许多生产用例,成本节省($0 vs $0.10-0.50/秒)胜过质量差异。
Q: 我能用 Open-Sora 在自己视频数据集微调吗? #
A: 可以。Open-Sora 发布完整训练管道,包括数据预处理脚本、训练配置、ColossalAI 集成。微调 11B 模型需 8x A100/H100 GPU 合理吞吐,但 LoRA 微调(减少 99% 可训练参数)可在 2x A100 40GB 运行。数据预处理管道自动处理视频字幕、分辨率过滤、运动分数计算。
Q: T2V 和 T2I2V 生成有何不同? #
A: 直接 T2V(文本到视频)单次扩散过程从文本提示生成视频。T2I2V(文本到图像到视频)首先生成高质量关键帧用 FLUX,然后用 I2V 管道动画。T2I2V 视觉质量和时间一致性显著更好,代价 ~30% 额外推理时间。生产用推荐 T2I2V。
Q: 我如何部署 Open-Sora 为 API 服务? #
A: 用 FastAPI 应用包装推理管道 GPU worker 队列。用 Redis 或 RabbitMQ 任务分发,GPU 节点运行推理 worker。仓库包含 Gradio 应用(gradio/app.py)参考实现。生产加请求验证、速率限制、输出缓存。完整 FastAPI 样板在仓库 examples/api_server/ 目录。
Q: 哪种提示格式与 Open-Sora 最佳配合? #
A: 详细描述提示显式场景构图产生最好结果。包括:(1) 主体描述,(2) 动作或运动,(3) 环境和光照,(4) 相机角度和运动,(5) 风格或情绪关键词。50-100 词提示通常优于短提示。内置提示精炼(用 GPT-4)自动扩展短提示到详细描述。
Q: Apache-2.0 许可证允许商业用途吗? #
A: 可以。Apache-2.0 许可证允许商业使用、修改、分发、私人使用,只要包括原版权声明和许可证文本。生成内容无限制——你拥有用 Open-Sora 创建视频。专利权利明确授予,其他一些开源许可证不这样。
加入社区 #
- GitHub: hpcaitech/Open-Sora
- 文档: hpcaitech.github.io/Open-Sora
- Discord: HPC-AI Discord
本文由 Dibi8 编辑团队独立研究撰写。我们可能从联盟链接获得佣金,但这不影响编辑独立性。
💬 留言讨论