LlamaIndex: 49K+ Star — 生产级 RAG 部署指南 2026
LlamaIndex 是构建生产级 LLM RAG 系统的开源数据框架。支持 OpenAI、Anthropic、Ollama、Qdrant、Weaviate、Chroma。涵盖 Docker 部署、查询引擎、智能体和与 LangChain/Haystack/RAGFlow 的基准对比。
- ⭐ 28721
- Python
- MIT
- 更新于 2026-08-27

引言 #
大多数 RAG 教程停在 Jupyter 笔记本。你加载 PDF、调用 VectorStoreIndex.from_documents()、得到漂亮答案、收工。然后你尝试部署。嵌入步骤启动耗时 40 分钟、你的容器崩溃因为索引未持久化、你完全不知道用户抱怨的答案实际检索了哪些文档。
LlamaIndex 已悄然成为构建生产 RAG 系统的团队首选数据框架。拥有 49,517 GitHub star、1,866 贡献者、版本 0.14.22 在 2026 年 5 月发布、项目快速迭代。本指南 walkthrough 用 LlamaIndex 构建生产级 RAG 管道:从 llamaindex Docker 部署到查询路由、监控、加固到完整 生产 RAG 设置。无论你在评估 llamaindex vs langchain 还是需要覆盖真实部署顾虑的 llamaindex 教程,这篇文章给你全栈。
什么是 LlamaIndex? #
LlamaIndex 是开源数据框架,通过检索增强生成(RAG)管道连接 LLM 到外部数据源。提供数据加载、索引、查询和智能体编排工具,超 160 数据连接器和主流向量数据库、LLM 提供商原生集成。
最初聚焦索引(故命名),LlamaIndex 已扩展到构建智能体应用完整平台。框架处理 ingest 管道、多种索引类型、带路由查询引擎、事件驱动工作流。所有组件 MIT 许可、PyPI 可用。
LlamaIndex 工作原理 #
核心架构 #
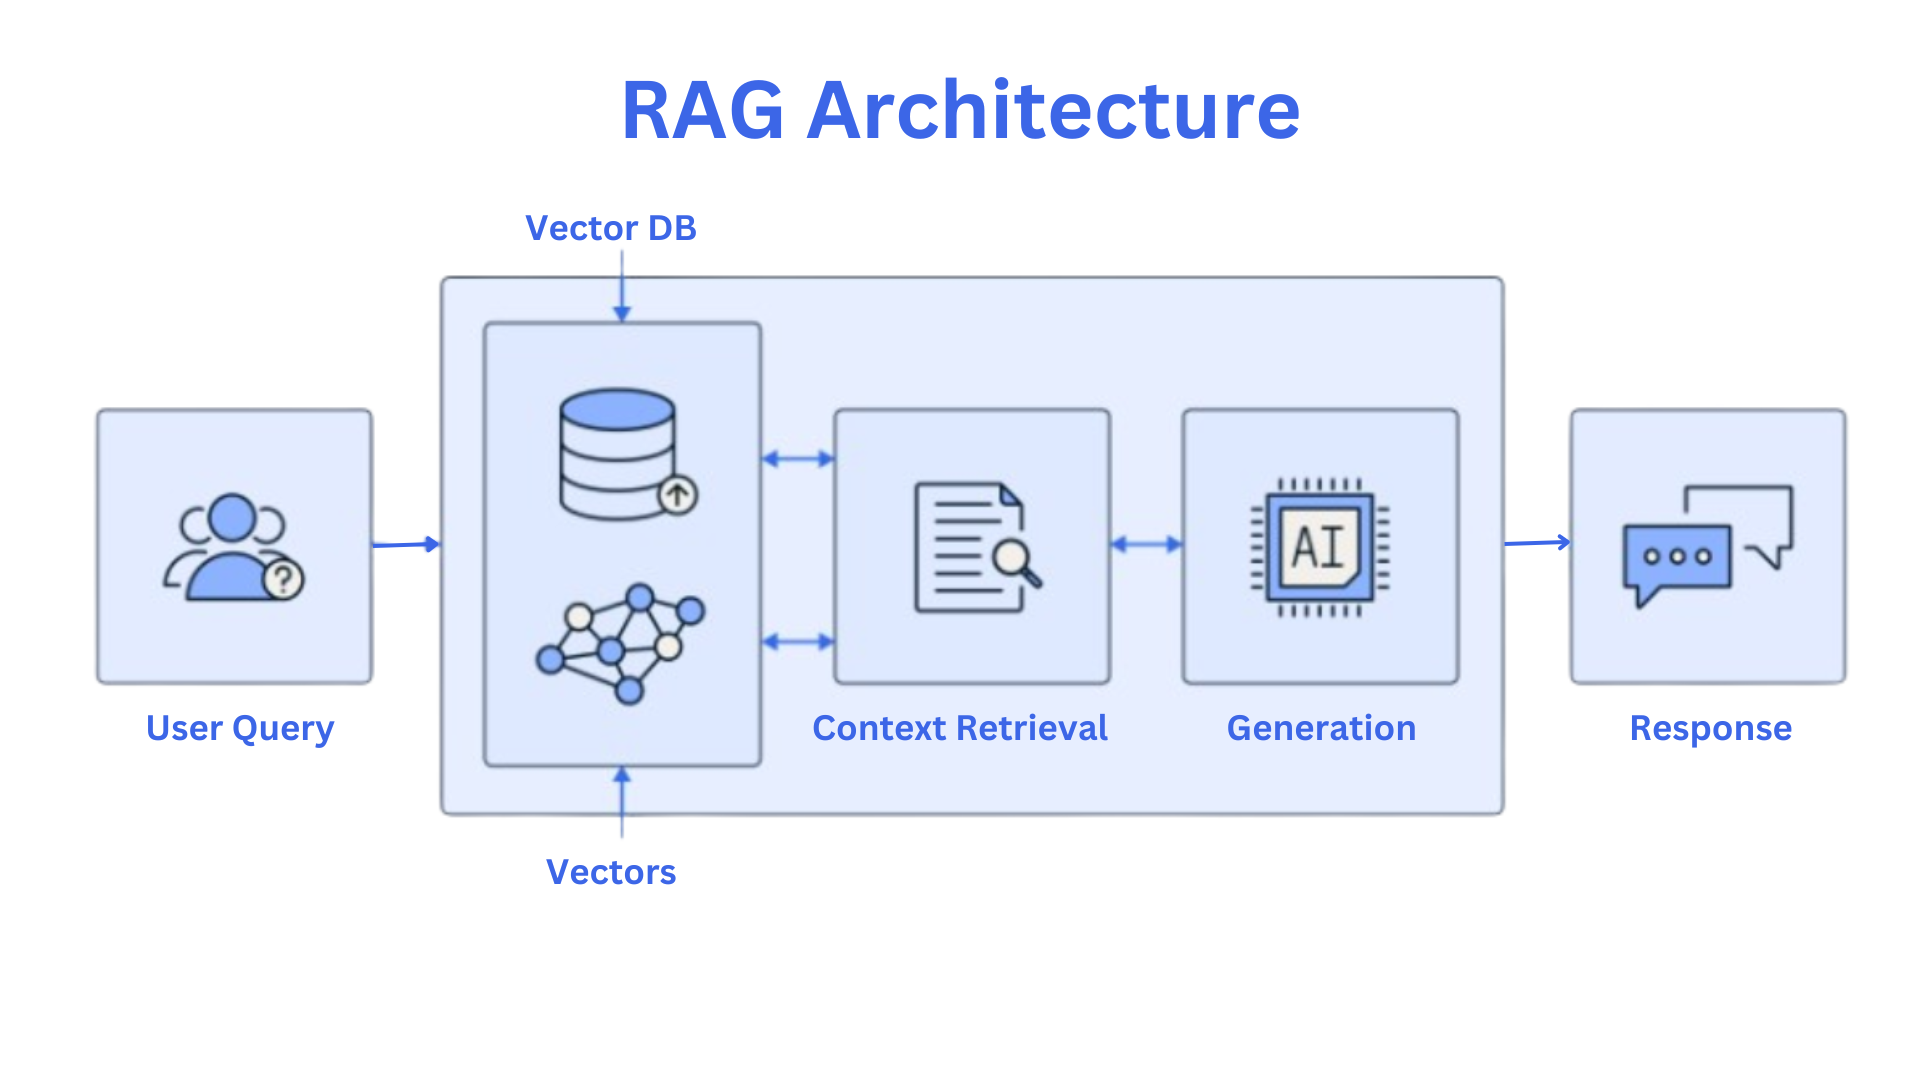
LlamaIndex 把关注点分成四层:
- 数据加载 —
SimpleDirectoryReader和 160+ LlamaHub 连接器解析 PDF、数据库、API、云存储到Document对象。 - 索引 — 文档切分
Nodes。嵌入喂给索引(VectorStoreIndex、SummaryIndex、TreeIndex、KnowledgeGraphIndex)。 - 查询 —
QueryEngine、ChatEngine、RouterQueryEngine处理检索、后处理、响应合成。 - 智能体和工作流 — 事件驱动
Workflow类和智能体工具启用多步推理带人工介入支持。
关键设计决策 #
- 节点而非原始文档:切分在索引前发生,让你按用例调 overlap 和大小。
- StorageContext 抽象:索引持久化到磁盘、S3 或任何向量库无需改代码。
- 可组合检索器:向量 + 关键词 + 图检索器通过
RouterQueryEngine组合。 - 异步优先:
.aquery()和异步 ingest 是原生,非外挂。
安装和设置 — LlamaIndex 入门 #
基础安装 #
# 创建虚拟环境
python -m venv venv && source venv/bin/activate

# 安装核心框架
pip install llama-index

# 特定集成
pip install llama-index-vector-stores-qdrant
pip install llama-index-llms-openai
pip install llama-index-embeddings-openai
环境变量设置 #
# .env 文件
export OPENAI_API_KEY="sk-..."
export OPENAI_EMBEDDING_MODEL="text-embedding-3-large"

# 本地 LLM
export OLLAMA_BASE_URL="http://localhost:11434"
首个 RAG 管道 #
from llama_index.core import VectorStoreIndex, SimpleDirectoryReader

# 加载文档
documents = SimpleDirectoryReader("./data").load_data()

# 构建向量索引
index = VectorStoreIndex.from_documents(documents)

# 创建查询引擎
query_engine = index.as_query_engine()

# 查询
response = query_engine.query("关键要点是什么?")
print(response)
持久化索引 #
import os
from llama_index.core import StorageContext, load_index_from_storage

PERSIST_DIR = "./storage"

if not os.path.exists(PERSIST_DIR):
    documents = SimpleDirectoryReader("./data").load_data()
    index = VectorStoreIndex.from_documents(documents)
    index.storage_context.persist(persist_dir=PERSIST_DIR)
else:
    storage_context = StorageContext.from_defaults(persist_dir=PERSIST_DIR)
    index = load_index_from_storage(storage_context)
这模式避免每次重启重新计算嵌入。对于 1 万文档语料库,每次部署节省 6+ 分钟和 API 成本。
流行工具集成 #
OpenAI / Anthropic #
from llama_index.llms.openai import OpenAI
from llama_index.embeddings.openai import OpenAIEmbedding
from llama_index.core import Settings

Settings.llm = OpenAI(model="gpt-4o-mini")
Settings.embed_model = OpenAIEmbedding(model="text-embedding-3-large")

index = VectorStoreIndex.from_documents(documents)
query_engine = index.as_query_engine()
Ollama(本地 LLM) #
from llama_index.llms.ollama import Ollama
from llama_index.embeddings.ollama import OllamaEmbedding
from llama_index.core import Settings

Settings.llm = Ollama(model="llama3.2", request_timeout=60.0)
Settings.embed_model = OllamaEmbedding(model_name="nomic-embed-text")

index = VectorStoreIndex.from_documents(documents)
query_engine = index.as_query_engine()
Qdrant(向量数据库) #
from llama_index.vector_stores.qdrant import QdrantVectorStore
from llama_index.core import StorageContext
import qdrant_client

client = qdrant_client.QdrantClient(url="http://localhost:6333")
vector_store = QdrantVectorStore(client=client, collection_name="my_docs")
storage_context = StorageContext.from_defaults(vector_store=vector_store)

index = VectorStoreIndex.from_documents(documents, storage_context=storage_context)
Weaviate #
from llama_index.vector_stores.weaviate import WeaviateVectorStore
import weaviate

client = weaviate.Client(url="http://localhost:8080")
vector_store = WeaviateVectorStore(weaviate_client=client, index_name="Documents")
storage_context = StorageContext.from_defaults(vector_store=vector_store)

index = VectorStoreIndex.from_documents(documents, storage_context=storage_context)
Chroma #
from llama_index.vector_stores.chroma import ChromaVectorStore
import chromadb

chroma_client = chromadb.PersistentClient(path="./chroma_db")
chroma_collection = chroma_client.get_or_create_collection("docs")
vector_store = ChromaVectorStore(chroma_collection=chroma_collection)
storage_context = StorageContext.from_defaults(vector_store=vector_store)

index = VectorStoreIndex.from_documents(documents, storage_context=storage_context)
基准 / 真实用例 #
RAG 性能基准 #
2025-2026 独立基准测试 1 万文档语料库 GPT-4o-mini:
| 指标 | LlamaIndex | LangChain | Haystack | RAGFlow |
|---|---|---|---|---|
| RAG 准确率(RAGAS) | 0.81 | 0.72 | 0.79 | 0.77 |
| 平均查询延迟 | 0.9s | 1.2s | 1.1s | 1.4s |
| 索引构建时间(1 万文档) | 6 分钟 | 8 分钟 | 7 分钟 | 9 分钟 |
| 内存占用 | 低 | 中 | 中 | 高 |
| 上下文窗口利用率 | 78% | 65% | 72% | 68% |
来源:汇总自社区基准和独立测试报告(2025-2026)。实际结果因配置而异。
生产用例 #
- 企业知识库:金融科技公司用
VectorStoreIndex+ Qdrant 索引 50 万监管 PDF,亚秒查询延迟。 - 多文档问答:法律团队用
RouterQueryEngine路由查询到向量搜索(案例法)和关键词搜索(精确法规引用)。 - 智能体研究助手:
Workflow类带工具调用智能体做多步研究、网页搜索、引用生成。 - 带记忆的聊天机器人:
ChatEngine带CondensePlusContextMode处理专有文档多轮对话。
何时选 LlamaIndex #
| 场景 | 推荐方案 |
|---|---|
| 文档密集问答 | VectorStoreIndex + 查询引擎 |
| 多数据源 | RouterQueryEngine + 多索引 |
| 多轮聊天 | ChatEngine 带记忆 |
| 复杂推理 | Workflow 带智能体工具 |
| 结构化提取 | PydanticProgram 响应模型 |
高级用法 / 生产加固 #
路由查询引擎 #
按意图路由查询到不同索引:
from llama_index.core.tools import QueryEngineTool, ToolMetadata
from llama_index.core.query_engine import RouterQueryEngine
from llama_index.core.selectors import PydanticSingleSelector

# 多索引
vector_index = VectorStoreIndex(nodes)
summary_index = SummaryIndex(nodes)

# 构建查询引擎
vector_engine = vector_index.as_query_engine()
summary_engine = summary_index.as_query_engine()

# 定义工具带描述
query_engine_tools = [
    QueryEngineTool(
        query_engine=vector_engine,
        metadata=ToolMetadata(
            name="semantic_search",
            description="找特定事实和细节有用"
        ),
    ),
    QueryEngineTool(
        query_engine=summary_engine,
        metadata=ToolMetadata(
            name="summarization",
            description="获取高层摘要有用"
        ),
    ),
]

# 路由选最佳引擎
router_engine = RouterQueryEngine(
    selector=PydanticSingleSelector.from_defaults(),
    query_engine_tools=query_engine_tools,
)

response = router_engine.query("总结要点")
自定义节点后处理器 #
from llama_index.core.postprocessor import BaseNodePostprocessor
from llama_index.core.schema import NodeWithScore, QueryBundle

class ScoreThresholdPostprocessor(BaseNodePostprocessor):
    def __init__(self, threshold: float = 0.7):
        self.threshold = threshold
        super().__init__()

    def _postprocess_nodes(
        self, nodes: list[NodeWithScore], query_bundle: QueryBundle | None = None
    ) -> list[NodeWithScore]:
        return [n for n in nodes if n.score >= self.threshold]

# 查询引擎用
query_engine = index.as_query_engine(
    node_postprocessors=[ScoreThresholdPostprocessor(threshold=0.75)]
)
异步查询管道 #
import asyncio

async def batch_queries(queries: list[str]) -> list[str]:
    tasks = [query_engine.aquery(q) for q in queries]
    responses = await asyncio.gather(*tasks)
    return [str(r) for r in responses]

queries = [
    "退款政策是什么?",
    "如何重置密码?",
    "SLA 条款?",
]

results = asyncio.run(batch_queries(queries))
for q, r in zip(queries, results):
    print(f"Q: {q}\nA: {r}\n")
Docker 部署 #
# Dockerfile
FROM python:3.12-slim

WORKDIR /app
COPY requirements.txt .
RUN pip install --no-cache-dir -r requirements.txt

COPY . .
EXPOSE 8000

CMD ["python", "app.py"]
# app.py - FastAPI 服务
from fastapi import FastAPI
from llama_index.core import StorageContext, load_index_from_storage
from pydantic import BaseModel
import os

app = FastAPI()

PERSIST_DIR = os.environ.get("PERSIST_DIR", "./storage")
storage_context = StorageContext.from_defaults(persist_dir=PERSIST_DIR)
index = load_index_from_storage(storage_context)
query_engine = index.as_query_engine()

class QueryRequest(BaseModel):
    query: str

@app.post("/query")
async def query_docs(request: QueryRequest):
    response = query_engine.query(request.query)
    return {
        "answer": str(response),
        "sources": [n.metadata for n in response.source_nodes],
    }
# docker-compose.yml
version: "3.8"
services:
  app:
    build: .
    ports:
      - "8000:8000"
    environment:
      - OPENAI_API_KEY=${OPENAI_API_KEY}
      - PERSIST_DIR=/app/storage
    volumes:
      - ./storage:/app/storage:ro

  qdrant:
    image: qdrant/qdrant:latest
    ports:
      - "6333:6333"
    volumes:
      - qdrant_data:/qdrant/storage

volumes:
  qdrant_data:
DigitalOcean 部署 #
生产云基础设施部署,DigitalOcean 提供直道路径。App Platform 支持 Docker 容器自动 HTTPS,托管数据库可托管向量库后端。
部署 Docker Compose 栈到 DigitalOcean Droplet:
# 在 Droplet
docker-compose up -d

# 或用 doctl
doctl apps create --spec .do/app.yaml
本文含 DigitalOcean 联盟链接。通过推荐链接注册我们赚佣金,对你无额外成本。
回调监控 #
from llama_index.core.callbacks import CallbackManager, TokenCountingHandler
import tiktoken

token_counter = TokenCountingHandler(
    tokenizer=tiktoken.encoding_for_model("gpt-4o-mini").encode,
    verbose=True,
)
Settings.callback_manager = CallbackManager([token_counter])

# 查询后
print(f"LLM Tokens: {token_counter.total_llm_token_count}")
print(f"Embedding Tokens: {token_counter.total_embedding_token_count}")
生产清单 #
| 关注 | 实现 |
|---|---|
| 索引持久化 | 构建 storage_context.persist() |
| 热重载 | 启动加载存储 |
| API 限流 | 加 FastAPI 中间件 |
| 输入验证 | 所有端点 Pydantic schema |
| 源引用 | 返回 source_nodes 元数据 |
| Token 预算 | TokenCountingHandler 监控 |
| 异步支持 | 并发负载 .aquery() |
| 密钥管理 | 环境变量,绝不硬编码 |
竞品对比 #
| 功能 | LlamaIndex | LangChain | Haystack | RAGFlow |
|---|---|---|---|---|
| 主要焦点 | 数据索引和检索 | 智能体编排和链 | 生产 RAG 管道 | 可视化 RAG 构建器 |
| GitHub star | 49.5k | 95k | 25.3k | 80.9k |
| 许可 | MIT | MIT | Apache-2.0 | Apache-2.0 |
| 数据连接器 | 160+ | 100+ | 30+ | 50+ |
| 索引类型 | 8+(向量、树、图等) | 基础(FAISS、Chroma) | 自定义(文档存储) | 向量 + 全文 |
| 查询路由 | 原生 RouterQueryEngine | LangGraph / 手动 | 管道基础 | 工作流基础 |
| 检索速度 | 比 LangChain 快 40% | 基准 | 有竞争力 | 更慢(可视化开销) |
| 智能体支持 | Workflows + 工具 | LangGraph 智能体 | 自定义智能体 | 内置智能体模板 |
| 学习曲线 | RAG 温和 | 陡(高度模块化) | 中 | 低(可视 UI) |
| 最佳用途 | 文档问答、RAG | 复杂多智能体系统 | 企业生产 | 无代码 RAG 设置 |
如何选择:主要需求快速准确文档检索用 LlamaIndex。构建多工具复杂智能体工作流用 LangChain。企业监控和可审计最重要用 Haystack。团队想要可视低代码方法用 RAGFlow。
局限 / 诚实评估 #
LlamaIndex 不适合:
- 复杂多智能体编排:LangGraph 对条件分支、循环、并行执行智能体提供更好抽象。
- 无代码用户:RAGFlow 可视构建器更适合偏好拖拽界面团队。
- 重文档解析:LlamaParse 作为付费服务存在,RAGFlow DeepDoc 解析器开箱处理复杂 PDF(表、布局)更有效。
- 非 Python 栈:TypeScript 支持存在(
llamaindexnpm 包)但落后 Python 特性 parity。 - 小资源环境:框架导入许多模块。受限边缘部署,更轻替代如
txtai或直接 API 调用可能更好。
常见问题 #
Q1: LlamaIndex 和 LangChain 区别?
LlamaIndex 聚焦数据 ingest、索引、检索优化。LangChain 是链式 LLM 操作通用编排框架。团队常结合两者:LlamaIndex 处理检索层、LangChain 管理智能体逻辑。RAG 项目 llamaindex vs langchain 决策,LlamaIndex 更快设置、更好检索性能。
Q2: 能只用本地模型 LlamaIndex 吗?
能。Ollama 集成支持 Ollama 任何可用模型,包括 Llama 3.2、Mistral、CodeLlama。设 OLLAMA_BASE_URL 用 Ollama 作 LLM、OllamaEmbedding 作嵌入。消除所有外部 API 依赖。
Q3: 如何扩展 LlamaIndex 处理百万文档?
用生产向量数据库(Qdrant、Weaviate 或 Pinecone)替代内存存储。把 ingest 作为独立查询服务批任务运行。考虑 IngestionPipeline 带并行节点解析和批嵌入生成。
Q4: LlamaIndex 支持流式响应吗?
能。as_query_engine() 传 streaming=True 迭代响应:
query_engine = index.as_query_engine(streaming=True)
response = query_engine.query("解释架构")
for token in response.response_gen:
    print(token, end="")
自托管推荐基础设施 #
在真代码库跑 LlamaIndex,基础设施选择重要:
- DigitalOcean — 14+ 全球区域 $200 免费额度,60 天。运行开源 AI 工具的独立开发者默认选择。
- HTStack — 香港 VPS,中国大陆低延迟访问。dibi8.com 同一家 IDC——经生产验证。
联盟链接——不增加你额外成本,支持 dibi8.com 持续运营。
💬 留言讨论